Une page PDF décrit quoi dessiner. Sa structure logique décrit le sens du contenu
et l'ordre de lecture. Le module optionnel pdftoolkit/pdf-to-html utilise cette
seconde description pour dériver du HTML selon Deriving HTML from PDF 1.2,
publication PDF Association conservée avec son code source.
Ce tutoriel exécute réellement examples/01-derive-tagged-pdf.php depuis la
version retenue du module. Le PDF d'entrée, toutes ses pages rendues, le HTML
obtenu, les diagnostics JSON et le PHP complet apparaissent ci-dessous. Le HTML
est produit pendant la construction du site et ne remplace pas un résultat par
une illustration écrite à la main.
Installer le module optionnel
composer require "pdftoolkit/pdf-to-html:^0.1.0"
Cette commande installe le core et le lecteur comme dépendances. Une application utilisant seulement le core n'acquiert pas de conversion HTML. PHP 8.3+ avec DOM et mbstring est nécessaire.
Fournir le PDF et conserver des étapes explicites
L'exemple exécutable reçoit les chemins d'entrée et de sortie :
php examples/01-derive-tagged-pdf.php tests/Fixtures/tagged.pdf _build/derived.html
L'application lit le fichier choisi et fournit ses octets à DocumentReader.
ReadPdfSource parcourt la structure logique et les contenus acceptés pour
construire un TaggedDocument. Il distingue structure, texte Unicode, propriétés
et annotations plutôt que d'inférer un document à partir de coordonnées.
Dériver le document et examiner les diagnostics
HtmlDeriver résout rôles et namespaces, dérive attributs et contenus puis
sérialise le HTML sémantique. Le résultat expose explicitement HTML, CSS,
ressources et diagnostics. Le script écrit la sortie choisie et décrit son
opération en JSON. L'application choisit elle-même stockage et publication.
Le script écrit aussi chaque ressource retournée à côté du HTML et indique
son nom, son type et son SHA-256. Conserver ces fichiers avec le HTML lors d'une
copie. Dans l'application, écrire explicitement $result->assets ou adapter les
URL des ressources de manière cohérente. Les scripts fiables, s'ils sont activés
volontairement, deviennent des ressources pdf-script-<sha256>.js externes ;
l'exemple sûr n'en exporte aucun.
Lire les diagnostics avant publication. Un modèle source représentant un mécanisme ne garantit pas que l'adaptateur accepte tous les encodages de fontes, opérateurs, filtres ou mécanismes de chiffrement des PDF externes.
Comparer le sens plutôt que la mise en page
Examiner titres, paragraphes et ordre de lecture dans l'aperçu HTML, puis les comparer au PDF. Redistribution du navigateur et pagination PDF ont des buts distincts. Le module n'infère pas de structure absente, ne fait pas d'OCR et ne promet pas une reproduction au pixel. Le sandbox de l'aperçu n'autorise ni exécution de script ni soumission de formulaire.
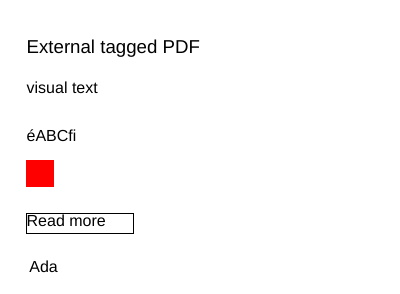
L'image rouge de la fixture contient un seul pixel d'échantillonnage, mais elle est peinte sur 20 points PDF de côté. L'adaptateur suit sa matrice de transformation et produit 27 × 27 pixels CSS après arrondi, selon 96 pixels CSS pour 72 points PDF. Il conserve ainsi la taille logique sans confondre échantillons et taille dessinée, ni reproduire chaque opération de positionnement/clipping.
Le profil par défaut n'exporte aucun runtime de script et n'autorise aucun chargement de ressource distante. L'application peut fournir explicitement les capacités de rendu/authentification ou activer le contenu fiable. Le pont optionnel des champs/événements couvre validation, calcul et reset courants, sans implémenter toute l'API Acrobat/ISO 21757-1. La matrice de couverture du module relie classes, tests individuels, oracle HTML5/PDF indépendant et harness Node du runtime.
Les fragments MathML conservent un vocabulaire contrôlé de 192 noms d'éléments, dont les MathML de présentation et de contenu. Préserver le balisage de contenu ou élémentaire ne garantit pas son rendu natif par le navigateur ; le vocabulaire étendu produit un diagnostic et le package ne fournit ni polyfill de rendu ni évaluateur mathématique.
Lire l'architecture du module, sa couverture et son guide de sécurité pour distinguer modèle, fichier et runtime. Un HTML sémantique ne certifie pas automatiquement l'accessibilité ou PDF/UA.
Voir le PDF d’entrée
Ce PDF balisé est l’entrée de la conversion. Le résultat HTML est produit par le script exécuté pendant la construction du site ; l’aperçu conserve la structure sémantique plutôt que la mise en page du PDF.
Utiliser le lecteur PDF du navigateur
Ce lecteur dépend du navigateur. Si le document ne s’affiche pas, utiliser « Ouvrir le PDF » ou « Télécharger ».
Résultat de la lecture
Sortie réelle du script exécuté sur le PDF d’entrée pendant la construction de cette documentation. Télécharger la sortie console.
{
    "input": "derive-html.pdf",
    "html": "derive-html.html",
    "htmlSha256": "5665b35850600e10e361dc3293b0e1f8ab81ebfec718ef3a829eecedf680d3fd",
    "cssBytes": 47,
    "assets": [
        {
            "filename": "image-b1ff9c8ea3a780bad09b346c423d2d0e46815926879b18e841d928376a946640.png",
            "mediaType": "image\/png",
            "sha256": "b1ff9c8ea3a780bad09b346c423d2d0e46815926879b18e841d928376a946640"
        }
    ],
    "diagnostics": [
        {
            "code": "scripts-disabled",
            "message": "PDF ECMAScript was not derived in the safe profile; use an explicitly trusted active-content profile for section 4.5 and Annex B.",
            "source": null
        },
        {
            "code": "associated-css-blocked",
            "message": "Associated stylesheets require an explicit active-content policy.",
            "source": "theme.css"
        }
    ]
}
Résultat HTML
Sortie réelle de la dérivation, isolée dans une frame sans autorisation de script, de formulaire ou de navigation de la page principale.
Lire la source HTML
<!DOCTYPE html>
<html lang="fr-FR"><head><title>Independent tagged source</title><meta charset="UTF-8"><meta name="viewport" content="width=device-width, initial-scale=1"><style>.lead{margin-bottom:10.666667px;display:block}</style></head><body><nav hidden="" id="PDF-PageNavigation" role="doc-pagelist"><a href="#PDF-Page-1">Intro-i</a></nav><form name="acroform" id="acroform_id"></form><div id="pdf-se-1" data-pdf-se-type="Document" data-pdf-se-type-original="Document"><h1 id="heading" data-pdf-se-type="H1" data-pdf-se-type-original="CustomHeading"><span id="PDF-Page-1" role="doc-pagebreak" aria-label="Intro-i"></span>External tagged PDF</h1><p id="pdf-se-2" data-pdf-se-type="P" data-pdf-se-type-original="StyledP" class="lead" style="margin-bottom:10.666667px;display:block;text-align:center"><span lang="fr">Texte remplaçant</span></p><p id="pdf-se-3" data-pdf-se-type="P" data-pdf-se-type-original="P">éABCfi</p><figure id="pdf-se-4" data-pdf-se-type="Figure" data-pdf-se-type-original="Figure"><img src="data:image/png;base64,iVBORw0KGgoAAAANSUhEUgAAAAEAAAABCAIAAACQd1PeAAAADElEQVR4nGP4z8AAAAMBAQDJ/pLvAAAAAElFTkSuQmCC" width="27" height="27" alt="A red pixel"></figure><a id="pdf-se-5" data-pdf-se-type="Link" data-pdf-se-type-original="Link" href="#PDF-Page-1">Read more</a><input id="pdf-se-6" name="Person.Name" form="acroform_id" type="text" value="Ada" maxlength="50" spellcheck="true" required="" data-pdf-se-type="Form"></div></body></html>
Code source complet
Code de pdftoolkit/pdf-to-html · Consulter la source au commit documenté ↗ · Origine du PDF d’entrée ↗
Lire le script commenté : 01-derive-tagged-pdf.php
<?php

declare(strict_types=1);

require dirname(__DIR__) . '/vendor/autoload.php';

use PDF\Html\PdfToHtml;
use PDF\Reading\FileBytes;
use PDF\Reading\ReaderLimits;

// File access belongs to this application, not to the library's source objects.
$input = $argv[1] ?? dirname(__DIR__) . '/tests/Fixtures/tagged.pdf';
$output = $argv[2] ?? dirname(__DIR__) . '/_build/derived.html';
if (!stream_is_local($input) || !is_file($input)) {
    throw new RuntimeException('The input must identify an existing local PDF file.');
}
$stream = fopen($input, 'rb');
if ($stream === false) {
    throw new RuntimeException('The input PDF could not be opened.');
}
try {
    $maximum = (new ReaderLimits())->maxFileBytes;
    $bytes = stream_get_contents($stream, $maximum + 1);
} finally {
    fclose($stream);
}
if ($bytes === false || strlen($bytes) > $maximum) {
    throw new RuntimeException('The input PDF exceeds the configured file limit.');
}

// Parsing, interpretation and derivation are separate injectable objects.
// The default profile performs no network access and emits no active scripts.
$result = (new PdfToHtml())->convert(new FileBytes($bytes), basename($input));
$directory = dirname($output);
if (!is_dir($directory) && !mkdir($directory, 0777, true) && !is_dir($directory)) {
    throw new RuntimeException('The output directory could not be created.');
}
if (file_put_contents($output, $result->html) === false) {
    throw new RuntimeException('The derived HTML could not be written.');
}
foreach ($result->assets as $asset) {
    if (file_put_contents($directory . '/' . $asset->filename, $asset->bytes) === false) {
        throw new RuntimeException('A derived asset could not be written.');
    }
}

echo json_encode([
    'input' => basename($input),
    'html' => basename($output),
    'htmlSha256' => hash('sha256', $result->html),
    'cssBytes' => strlen($result->css),
    'assets' => array_map(static fn ($asset): array => ['filename' => $asset->filename, 'mediaType' => $asset->mediaType, 'sha256' => hash('sha256', $asset->bytes)], $result->assets),
    'diagnostics' => $result->diagnostics,
], JSON_THROW_ON_ERROR | JSON_UNESCAPED_UNICODE | JSON_PRETTY_PRINT) . "\n";