Les premières leçons construisent un graphe et écrivent un PDF. Celle-ci ouvre
un fichier existant avec le module optionnel pdftoolkit/pdf-reader et le core, aux versions publiées sélectionnées par le manifeste de sources. Elle
parcourt son arbre de pages, consulte ses attributs effectifs et demande
séparément le décodage de ses flux. Les dictionnaires, nombres et rectangles
restent des objets du core.
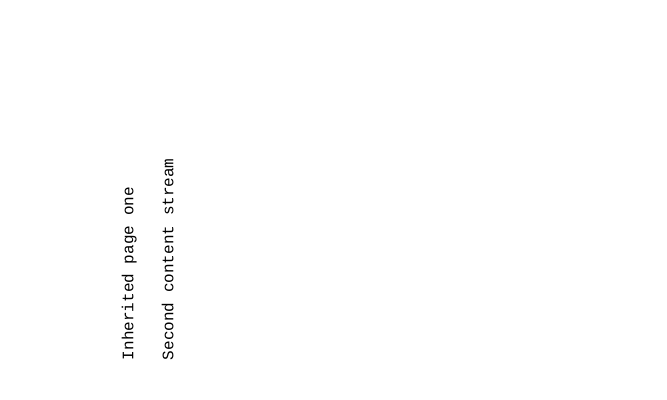
Le PDF d'entrée est une fixture originale créée avec pypdf et qpdf, indépendamment du writer PHP. Le script complet appartient au dépôt du lecteur. Sur le site, ses trois pages, sa sortie console réelle et son code commenté sont présentés après les explications.
Exécuter l'exemple
Dans une application indépendante, installer le lecteur depuis Packagist avec le core 0.5, puis exécuter le script distribué avec le module :
composer require "roukmoute/pdf:^0.5.5" "pdftoolkit/pdf-reader:^0.1.6"
php vendor/pdftoolkit/pdf-reader/examples/pages.php vendor/pdftoolkit/pdf-reader/tests/Fixtures/page-tree/classic.pdf
Depuis le checkout du core préparé comme indiqué dans
l'index des tutoriels, composer install installe
le lecteur comme dépendance de développement ; la même commande PHP fonctionne.
Le premier argument est un fichier d'entrée. Le script n'écrit aucun nouveau PDF. Pour utiliser la variante à flux xref et objets comprimés :
php vendor/pdftoolkit/pdf-reader/examples/pages.php vendor/pdftoolkit/pdf-reader/tests/Fixtures/page-tree/object-streams.pdf
Les identifiants des objets changent dans cette variante, mais l'ordre et les valeurs effectives des pages sont les mêmes. Pour une application indépendante, le guide des packages explique comment installer uniquement le core et le lecteur.
1. Ouvrir le document sans parcourir ses pages
L'application choisit le fichier et fournit ses octets :
use PDF\Reading\DocumentReader;
use PDF\Reading\FileBytes;

$document = (new DocumentReader())->read(new FileBytes($bytes));
DocumentReader contrôle le header, les références croisées, les révisions
et le catalogue. Son ReadDocument résout ensuite les objets à la demande,
avec des caches et des budgets propres à ce document. Cette ouverture ne
vérifie pas encore toutes ses pages ou ses ressources.
2. Parcourir et vérifier l'arbre
use PDF\Reading\PageTreeLimits;
use PDF\Reading\PageTreeReader;

$tree = (new PageTreeReader($document, new PageTreeLimits(
    maxDepth: 64,
    maxNodes: 10_000,
    maxPages: 5_000,
)))->read();
Le catalogue désigne une racine /Pages. Ses branches possèdent /Kids et
/Count ; ses feuilles sont des dictionnaires /Page. Le parcours suit
l'ordre de /Kids, vérifie les relations /Parent et compare chaque compte
déclaré au nombre de feuilles réellement rencontré. Les cycles et identités
répétées sont refusés.
ReadPageTree est comptable et itérable. count($tree) vaut trois pour cette
entrée ; $tree->page(0) donne la première page. Chaque ReadPage garde son
document propriétaire, sa référence et son dictionnaire source. Les limites
de profondeur, de nœuds et de feuilles appartiennent à ce parcours, en plus
des budgets de chargement du document.
3. Distinguer valeurs écrites et attributs effectifs
Quatre entrées sont héritables : /Resources, /MediaBox, /CropBox et
/Rotate. Le lecteur cherche l'ancêtre le plus proche qui les définit, puis
construit les PageAttributes de la feuille. CropBox utilise MediaBox par
défaut ; Rotate utilise zéro si aucun ancêtre ou page ne le définit.
Null est traité comme une absence.
| Page | Origine des attributs et particularité | Rotation brute / orientation |
|---|---|---|
| 1 | Hérite des ressources Courier et des deux rectangles de la branche. | -90 / 270 |
| 2 | Définit un MediaBox, une rotation zéro et des ressources vides ; hérite du CropBox de la sous-branche. | 0 / 0 |
| 3 | Hérite de la racine, sans reprendre les valeurs de la branche précédente. | 90 / 90 |
Un dictionnaire de ressources local remplace celui de l'ancêtre dans son
ensemble : il n'y a pas de fusion des catégories. C'est pourquoi les ressources
vides de la deuxième page n'utilisent aucune police héritée.
Les propriétés effectives sont un DictionaryType, deux Rectangle et un
IntegerType. normalizedRotation() calcule une orientation sans remplacer
l'entier original. Le dictionnaire source conserve ses seules entrées locales.
4. Consulter le contenu puis demander son décodage
/Contents est une entrée locale, jamais héritée. Elle peut désigner un flux
unique ou un tableau de flux. Sa résolution appartient à un service séparé :
use PDF\Reading\PageContentLimits;
use PDF\Reading\PageContentsReader;

$contentReader = new PageContentsReader($document, new PageContentLimits(
    maxStreams: 128,
));

foreach ($tree as $page) {
    $contents = $contentReader->read($page);
    foreach ($contents as $stream) {
        $encodedBytes = $stream->encodedBytes();
        $decodedBytes = $document->streamData($stream);
    }
}
PageContents conserve les EncodedStream séparément, dans leur ordre.
Ce service ne concatène pas les données et n'applique aucun filtre.
streamData() demande le décodage sous les budgets cumulatifs de
ReadDocument ; les demandes suivantes réutilisent son cache.
Les pages ont respectivement deux, deux et zéro flux. La première associe
un flux brut et un flux Flate. La deuxième utilise un tableau indirect,
dont un contenu possède des données binaires d'image en ligne. Ces données
contiennent même des mots tels que endstream : leur présence ne termine
pas le flux, dont les limites sont définies par /Length.
La troisième page omet /Contents et donne une collection vide.
Comprendre l'aperçu et la sortie console
La première page affiche deux lignes, avec la rotation héritée de sa branche. La deuxième apparaît vide : son image en ligne occupe une petite région près de l'origine, hors du CropBox. La troisième est vide puisqu'elle n'a aucun contenu. Cette entrée sert à vérifier des structures et des données binaires ; le nombre de flux ne prédit pas le nombre d'éléments visibles sur une page.
La sortie console indique trois pages vérifiées, leurs rectangles effectifs, leurs rotations et le nombre de catégories de ressources. Pour chaque flux, elle compare la longueur encodée et la longueur décodée. Ces octets restent du langage PDF : le lecteur ne les interprète pas pour extraire le texte ou rendre une page. Les aperçus du site sont produits indépendamment avec Poppler.
À essayer
- Lire la variante
object-streams.pdfet comparer ses références avec celles du fichier traditionnel. - Réduire
maxPagesà deux pour constater le refus de ce document à trois pages. - Consulter
$tree->page(0)->dictionary->get('Rotate')puis son attribut effectif : la première page n'écrit pas de rotation locale. - Conserver les flux sous leur forme encodée en omettant la demande
streamData().
Vérification et limites
Les fixtures indépendantes ont des valeurs attendues vérifiées avec pypdf et qpdf, puis avec les tests PHP. La documentation conserve exactement les octets de l'entrée, exécute le script du module verrouillé et rend ses trois pages.
Le parcours ne valide pas toutes les ressources, annotations ou actions du PDF. Le chiffrement, les références hybrides, PDF 2.0 et les codecs non implémentés restent refusés. L'import dans le writer, la fusion, la réécriture, l'extraction de texte et le rendu nécessitent leurs mécanismes dédiés. Le guide du lecteur et ses contrôles de sécurité précisent les responsabilités et les budgets.
Références : ISO 32000-1:2008, 7.7.3 et tableaux 29–30 pour l'arbre, les pages et l'héritage ; 7.8.2 pour les flux de contenu ; 7.9.5 pour les rectangles.
← 11. Révisions incrémentales · Tous les tutoriels
Voir le PDF d’entrée
Ce PDF est l’entrée du lecteur : une fixture originale créée avec pypdf et qpdf, indépendamment du writer PHP. Ses trois pages sont reproduites ci-dessous ; le résultat de la lecture figure ensuite dans la sortie console.
Utiliser le lecteur PDF du navigateur
Ce lecteur dépend du navigateur. Si le document ne s’affiche pas, utiliser « Ouvrir le PDF » ou « Télécharger ».
Résultat de la lecture
Sortie réelle du script exécuté sur le PDF d’entrée pendant la construction de cette documentation. Télécharger la sortie console.
Verified pages: 3
Page 1 (14 0 R): MediaBox [0 0 300 500]; CropBox [20 30 280 470]; Rotate -90 (orientation 270); resource categories 2
  Content streams: 2
  Stream 1: 55 encoded bytes, 55 decoded bytes
  Stream 2: 64 encoded bytes, 58 decoded bytes
Page 2 (18 0 R): MediaBox [0 0 320 520]; CropBox [30 40 270 460]; Rotate 0 (orientation 0); resource categories 0
  Content streams: 2
  Stream 1: 337 encoded bytes, 337 decoded bytes
  Stream 2: 21 encoded bytes, 19 decoded bytes
Page 3 (19 0 R): MediaBox [0 0 400 600]; CropBox [10 20 390 580]; Rotate 90 (orientation 90); resource categories 2
  Content streams: 0
Code source complet
Code de pdftoolkit/pdf-reader · Consulter la source au commit documenté ↗ · Origine du PDF d’entrée ↗
Lire le script commenté : pages.php
<?php

declare(strict_types=1);

use PDF\Reading\DocumentReader;
use PDF\Reading\FileBytes;
use PDF\Reading\PageContentLimits;
use PDF\Reading\PageContentsReader;
use PDF\Reading\PageTreeLimits;
use PDF\Reading\PageTreeReader;

$autoload = dirname(__DIR__) . '/vendor/autoload.php';
if (!is_file($autoload)) {
    // An installed package uses its application's autoloader.
    $autoload = dirname(__DIR__, 3) . '/autoload.php';
}
if (!is_file($autoload)) {
    throw new RuntimeException('Install the Composer dependencies before running this example.');
}
require $autoload;

// 1. The application chooses a local file. The reader receives only its bytes.
$path = $argv[1] ?? dirname(__DIR__) . '/tests/Fixtures/page-tree/classic.pdf';
if (str_contains($path, '://') || str_contains($path, "\0")) {
    throw new InvalidArgumentException('Choose a local PDF path.');
}
$bytes = file_get_contents($path);
if ($bytes === false) {
    throw new RuntimeException('Could not read the chosen PDF.');
}
$document = (new DocumentReader())->read(new FileBytes($bytes));

// 2. This operation traverses the entire tree: Count and Parent are checked,
//    Kids order is preserved, and the four inheritable attributes are resolved.
//    These limits bound indirect traversal independently of syntax depth.
$tree = (new PageTreeReader($document, new PageTreeLimits(maxDepth: 64, maxNodes: 10000, maxPages: 5000)))->read();
printf("Verified pages: %d\n", count($tree));
$contentReader = new PageContentsReader($document, new PageContentLimits(maxStreams: 128));
foreach ($tree as $index => $page) {
    // 3. Effective values are core objects. The source dictionary retains only
    //    its local entries; it is neither modified nor imported.
    printf(
        "Page %d (%s R): MediaBox %s; CropBox %s; Rotate %d (orientation %d); resource categories %d\n",
        $index + 1,
        $page->reference->identifier,
        $page->attributes->mediaBox,
        $page->attributes->cropBox,
        $page->attributes->rotate->integer(),
        $page->attributes->normalizedRotation(),
        count($page->attributes->resources),
    );

    // 4. Contents belongs only to this page. Inspection preserves separate
    //    streams in order, including their filters and encoded bytes.
    $contents = $contentReader->read($page);
    printf("  Content streams: %d\n", count($contents));
    foreach ($contents as $ordinal => $stream) {
        // Decoding is requested here under the document's cumulative budgets.
        // The resulting bytes remain PDF instructions, without text extraction.
        $decoded = $document->streamData($stream);
        printf("  Stream %d: %d encoded bytes, %d decoded bytes\n", $ordinal + 1, strlen($stream->encodedBytes()), strlen($decoded));
    }
}